以mlsys asst2 distributed training对mlsys DP TP ZeRO进行初识
naiive parallel

megatron-style

知识
Model Parallel(MP)
在这个作业里面没有涉及到Pipeline Parallel,因此是Tensor Parallel。
该定义为,将模型权重,分到各结点上。
模型权重
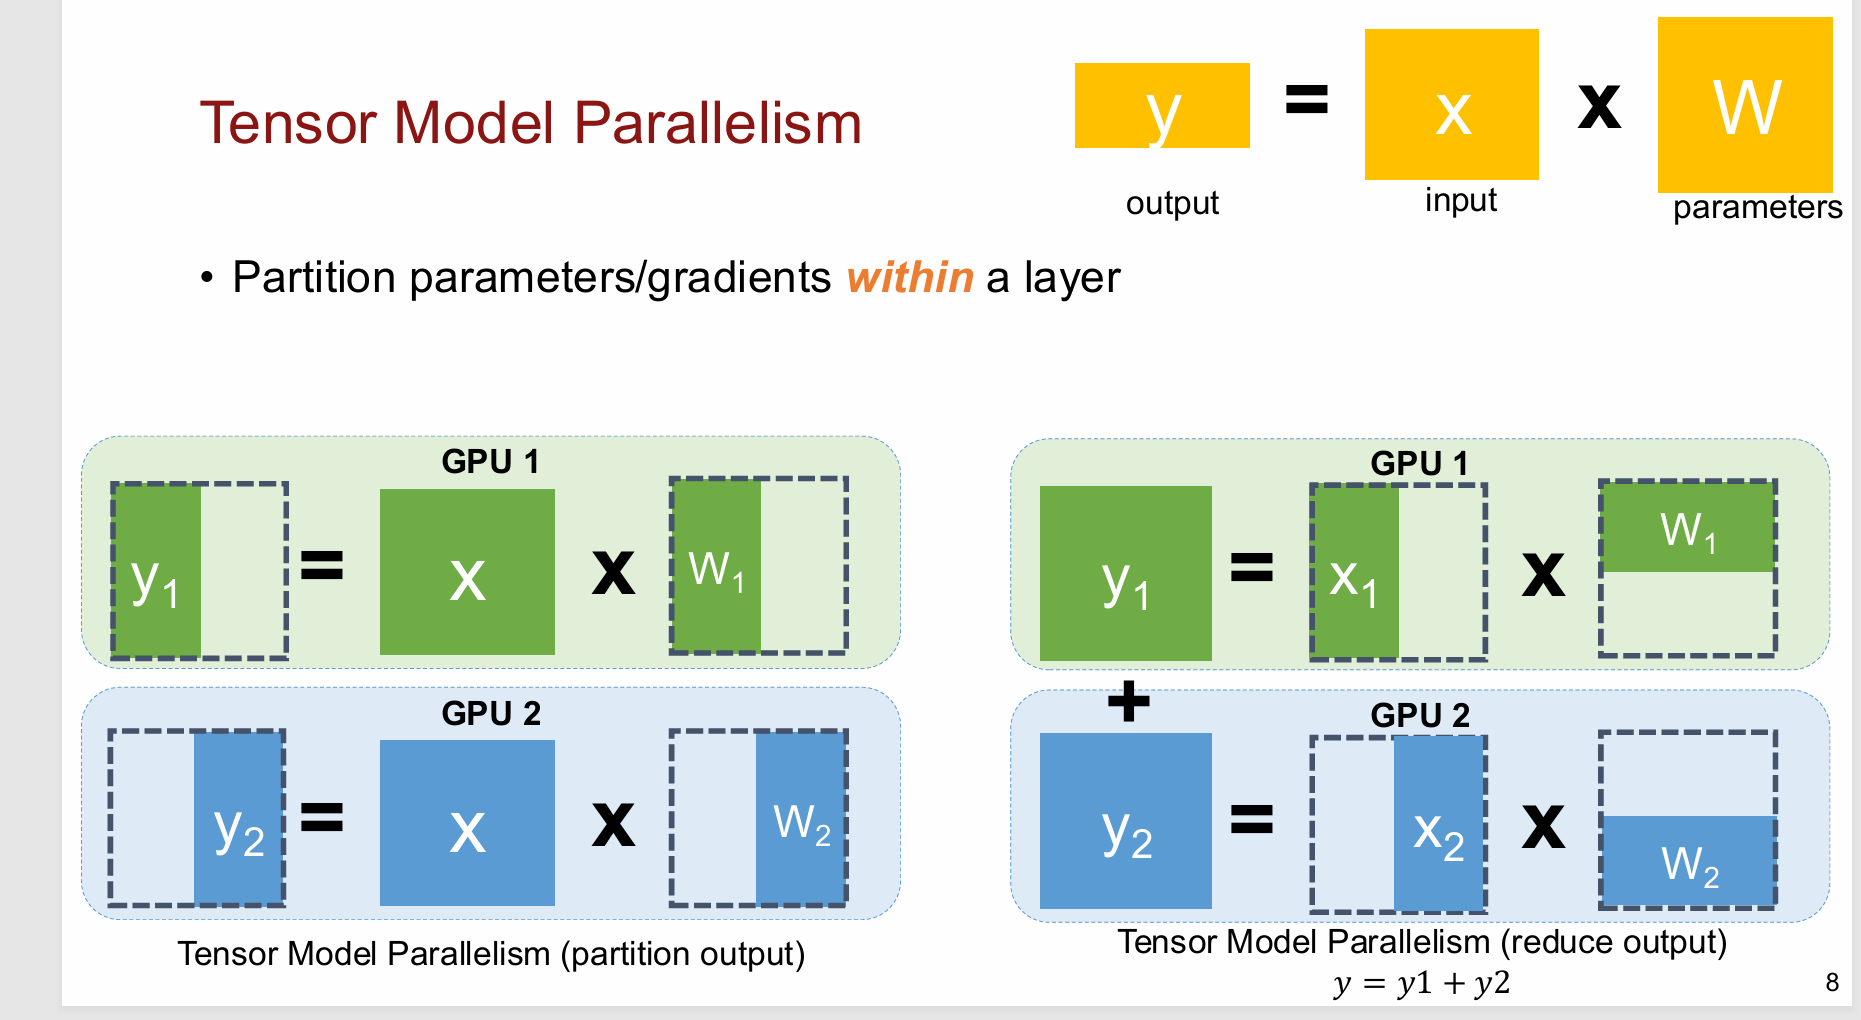
如下图Automated Discovery of Machine Learning Optimizations
forward
第一种MP,用X跟partial_W matmul得到的结果,直接all_gather就可以,也就是拼接。
第二种MP,由矩阵乘法对inner_loop的加法特性可知,最后结果进行reduce即可。
backward
几个求梯度的公式,output_grad(batch_size, out_dim), x(batch_size, in_dim), w(in_dim, out_dim), b(1, out_dim) grad与对应forward的shape相同。
x
1. # w_grad = x.T @ output_grad2. # b_grad = sum(output_grad, axis=0)3. # grad_x = output_grad @ w.Toutput_grad (batch_size, out_dim)
第一种,最终节点返回的梯度为output_grad,此时每个节点都是相同的grad,按上图分离为y1,y2即可
第二种,直接返回output_grad到上一层。
x_grad (batch_size, in_dim)
第一种,不同节点是不同的W,求到的grad_x也是不同的,且X的shape一致,没有被split掉,根据公式3,每个节点求到了自己的grad_x后,需要在不同节点之间进行reduce求和,累加梯度之后再分回每个节点,因此对应reduce_scatter操作。
第二种,因为x被split掉了,几个节点间没有关系,直接返回grad_x到上一层即可。
当然上述例子可以直接用求梯度公式去理解。比如第一种他的backward,对x求梯度的话,相当于把W转置,那么就变成了正向第二种的reduce方法了。其他同理。
Data Parallel(DP)
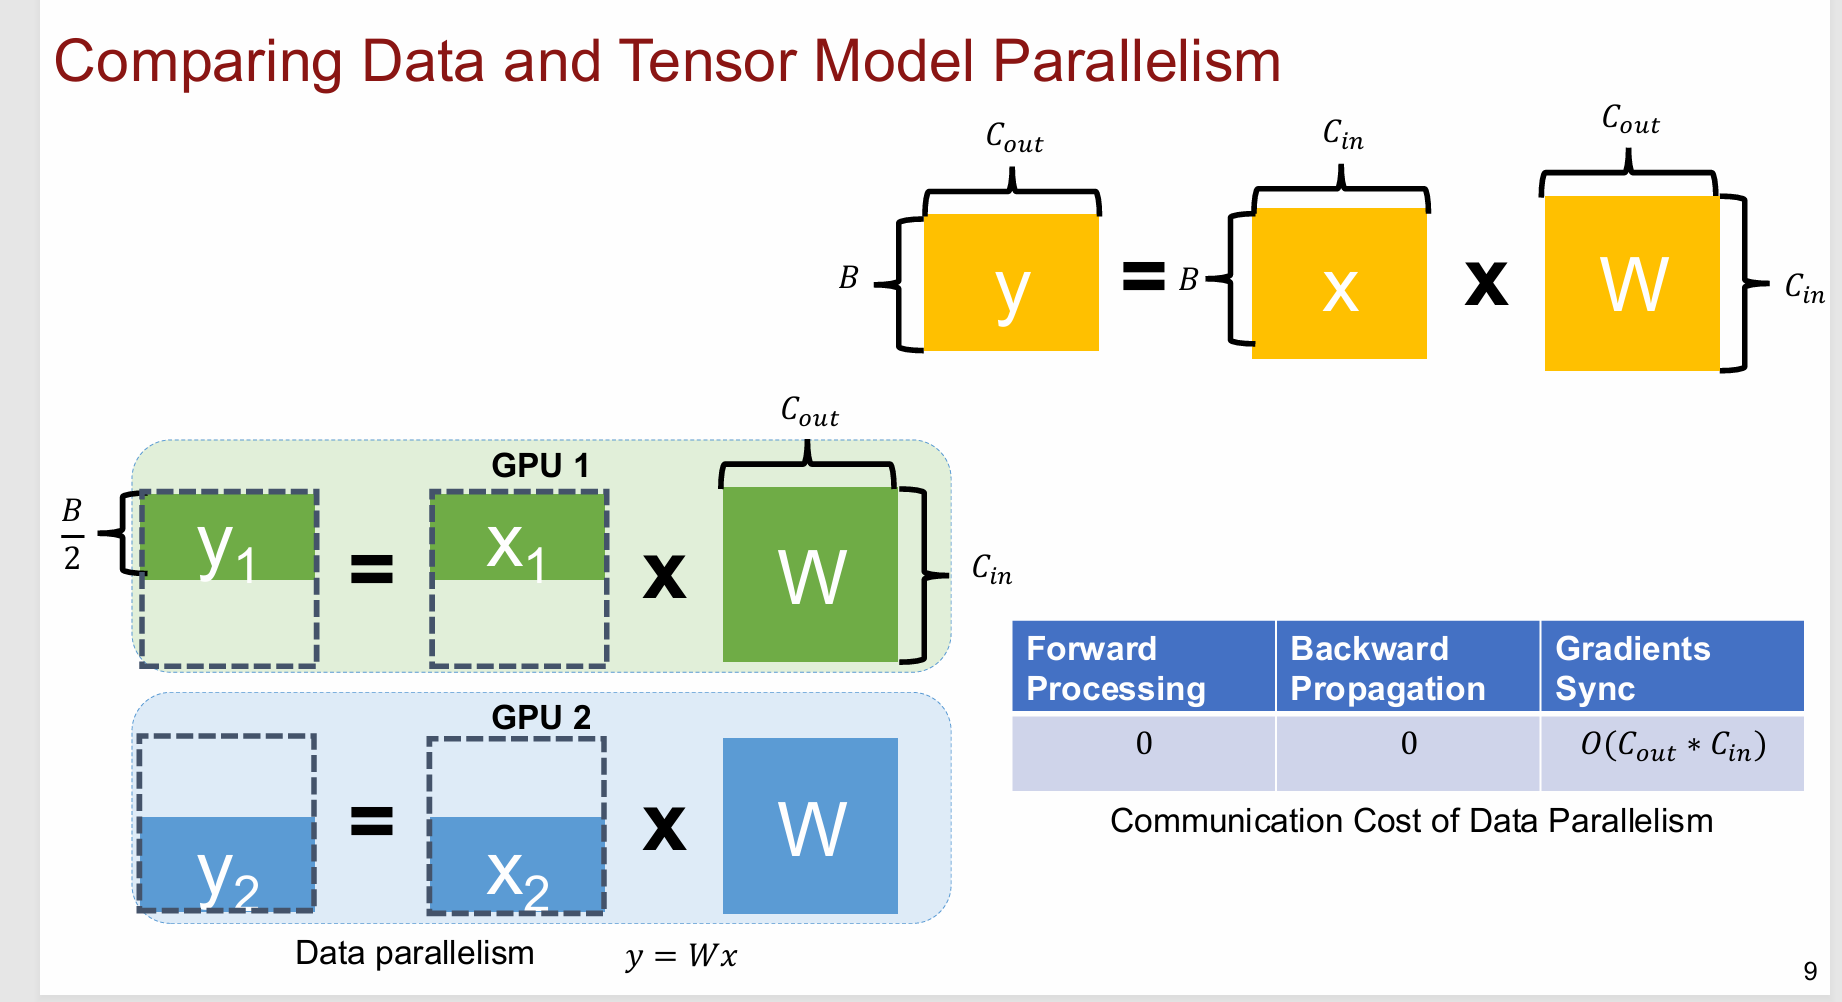
将模型的输入数据,依据batch维度,分到各结点上。Automated Discovery of Machine Learning Optimizations
forward
正常计算乘法即可
backward
每个节点计算出grad_w之后,由公式1可知,因为x的不同导致梯度不同。但DP是所有节点都是相同权重的,因此要进行累加。
由梯度下降法知道,累加之后还需要除以并行度,也就是节点个数。
MP + DP
这二者应该怎么结合呢?对MP来说,不同节点间的X应该完全一致,对DP来说,不同节点之间权重都是模型权重。
我们看如下图mlsyscourse/assignment-distributed-training

rank代表GPU节点们。上图通过对数据在batch维度上分为4份,就实现了DP,此时,对相同的一个DP桶,将其所在的模型权重,进行MP,那么就完成了结合。
forward
每个DP桶之间是并行的,而MP之间需要对权重进行通信
backward
先用MP的backward机制求到对权重的梯度,然后最终进行DP上的backward汇总,从而更新整个模型(此时所有节点的权重都将被汇总梯度更新)。
ZeRO-DP
朴素DP,每个节点都要复制一份整个模型,包括weights、optimizer states、gradients
该论文将这三种状态都进行shard,从而让每个节点的内存占用减小,能够训练更加大的模型。
后来发展成DeepSpeed.
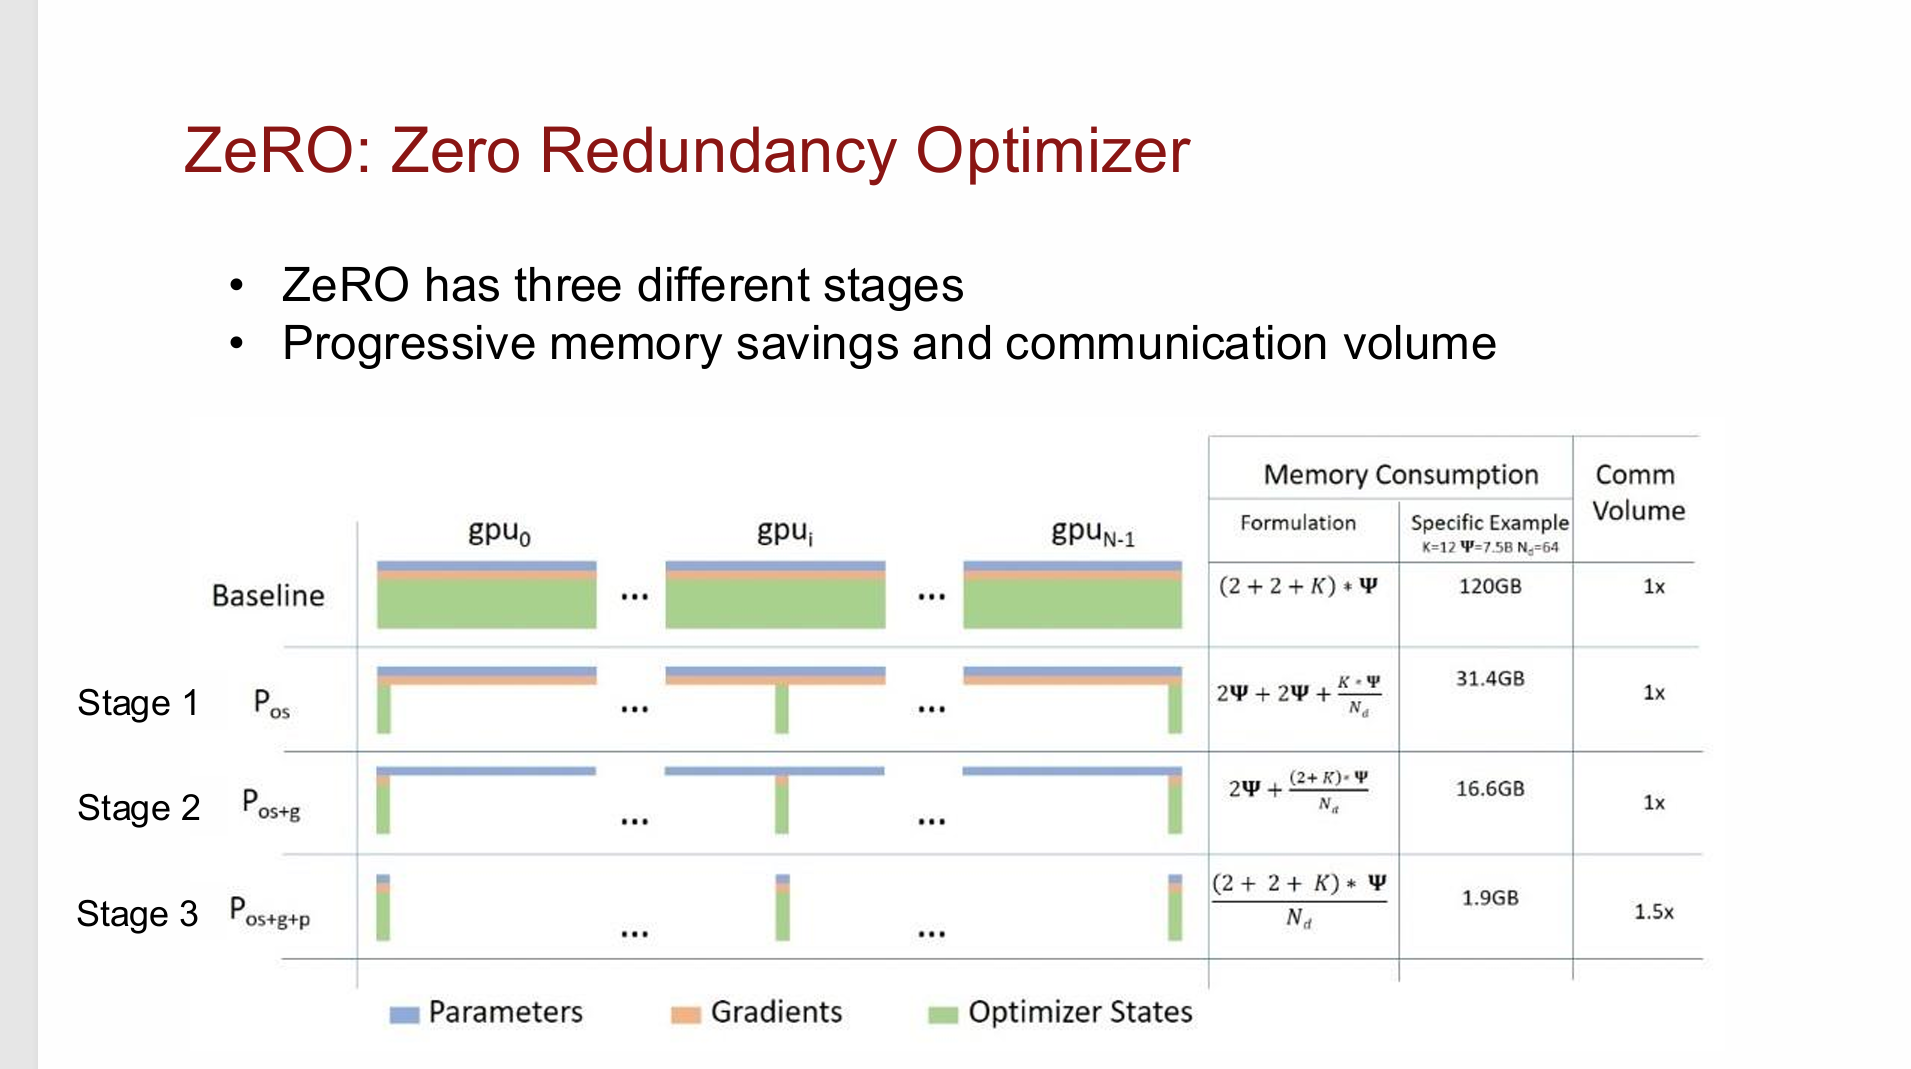
Parameters、Gradients
split
直接进行shard,均分到各个节点。每个节点存只属于自己的weight、grad_weight
forward
将Parameter进行Allgather,然后才能与输入的完整的X进行计算。
计算完之后立马抛弃掉Allgather出来的完整权重
backward
output_grad(batch_size, out_dim)
xxxxxxxxxx1. # w_grad = x.T @ output_grad2. # b_grad = sum(output_grad, axis=0)3. # grad_x = output_grad @ w.T由上述公式可知,前两个的梯度不需要进行通信等操作。因此直接计算。(此时有forward存下来的完整X,以及这个激活的output_grad)
同样的,由于x不同,需要进行累加,因此为reduce_scatter。
对于grad_x,还是需要对权重进行Allgather,计算后马上丢弃。
Optimizer States (作业以Adam为例)
每个层、每个权重,只存自己的Optimizer State,Adam如下Adam: A Method for Stochastic Optimization
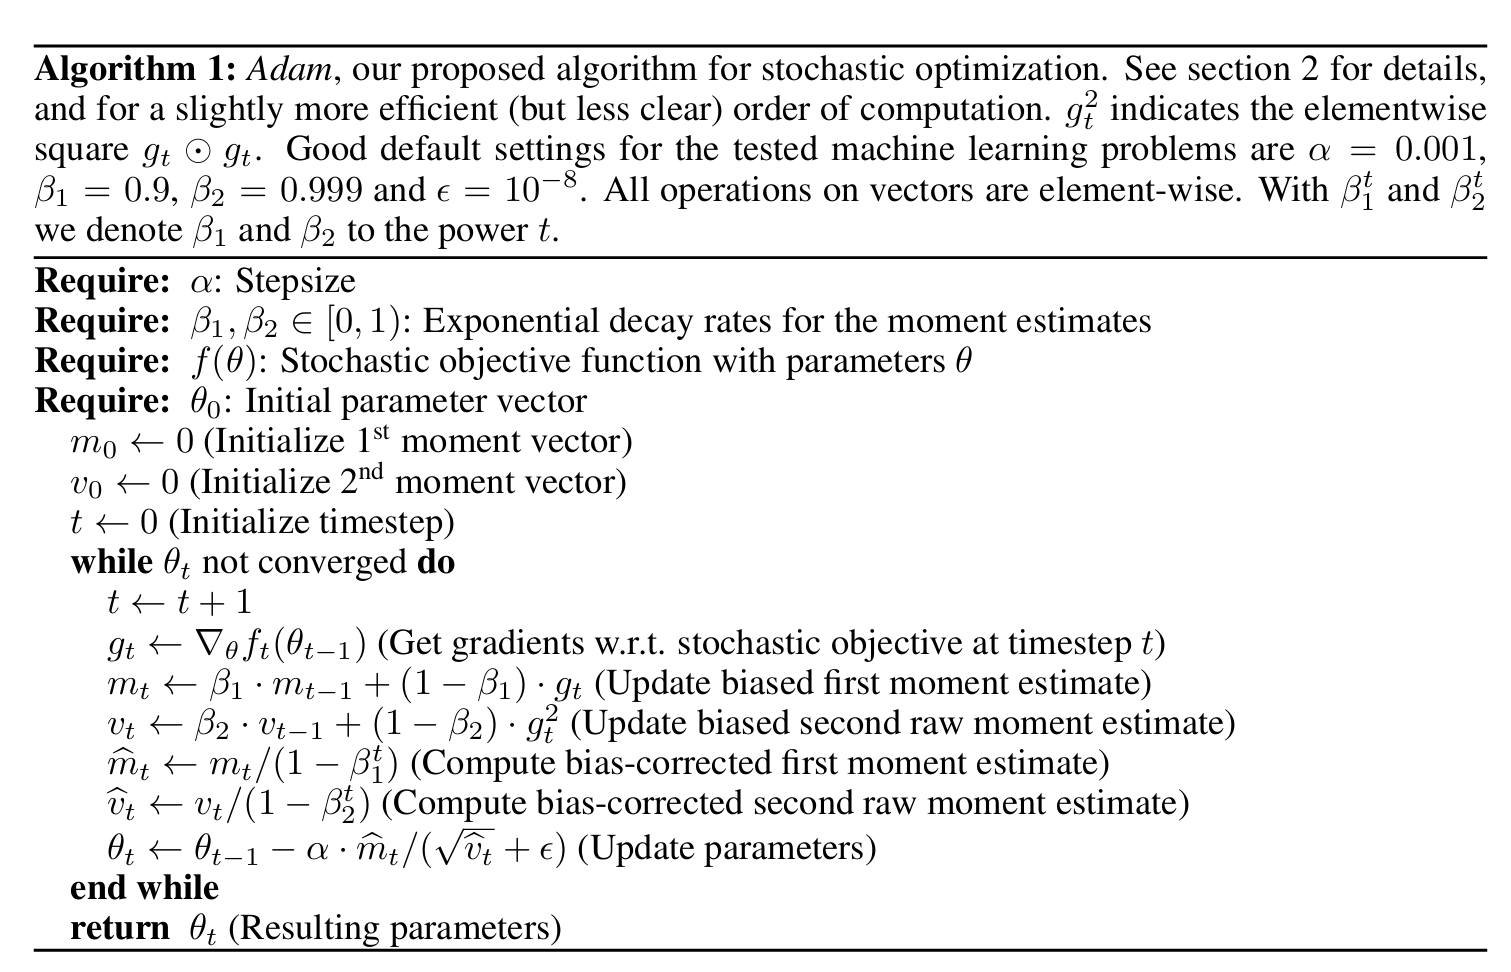
可以发现对每个参数,他们的优化器状态只跟他们自己参数的梯度有关,因此不需要进行任何通信就可以直接实现对这些状态的更新,实现代码如下:
xxxxxxxxxxfor key, param, grad in self._iter_sharded_params():            if key not in self.state:                self.state[key] = {                    "m": np.zeros_like(param),                    "v": np.zeros_like(param),                }
            m = self.state[key]["m"]            v = self.state[key]["v"]
            m = self.beta1 * m + (1 - self.beta1) * grad            v = self.beta2 * v + (1 - self.beta2) * grad * grad
            self.state[key]["m"] = m            self.state[key]["v"] = v
            m_hat = m / (1-(self.beta1 ** self.step_idx))            v_hat = v / (1-(self.beta2 ** self.step_idx))
            param -= self.lr * m_hat / (np.sqrt(v_hat) + self.eps)
可能看上去跟单线程的一模一样。没错就是一模一样。只是不同结点所存的权重都是已经被shard的,因此这些state也是shard的。
Experiment. Training (num_nodes=8)
实验环境:
windows11 + WSL 2
CPU:i9-13900H,分配给WSL 20个vCPU
内存:16G,分配给WSL 7.57G
实验1. naive parallel
通信点分析
MP
forward: mp_comm Allgather(y_fc1), Allgather(y_fc2)
backward: Reduce_scatter(grad_x)
DP
Allreduce(weight)
mp_size = 2, dp_size = 4
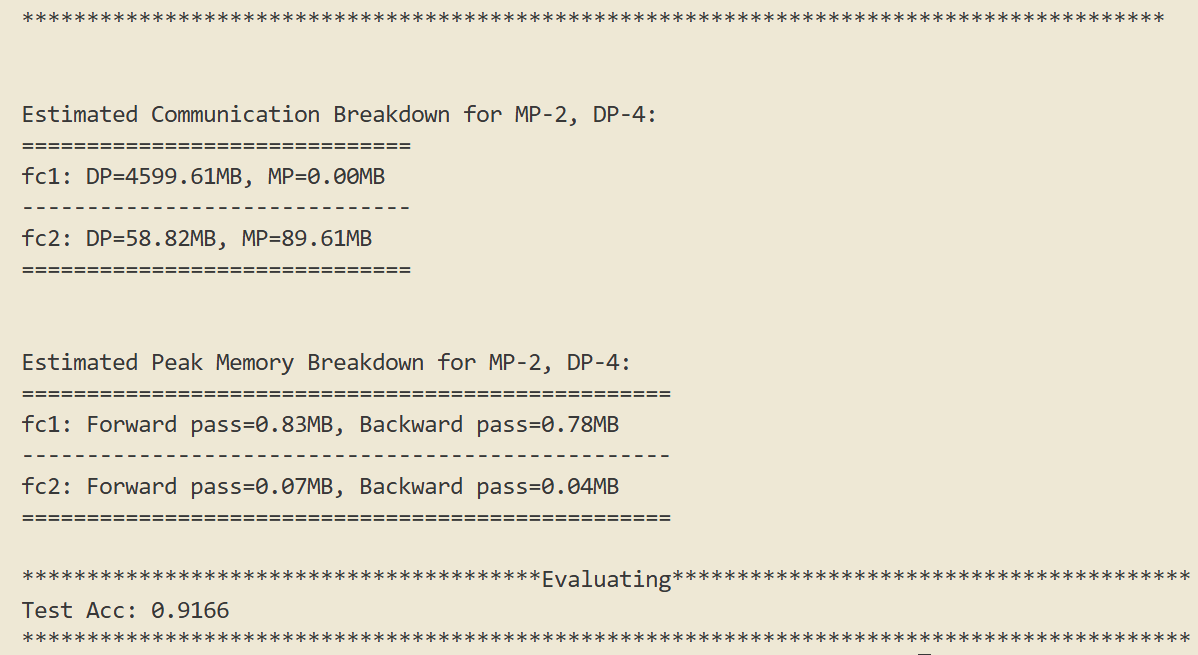
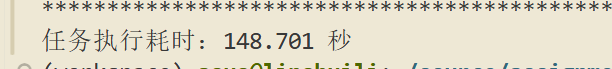
mp_size = 1, dp_size = 8
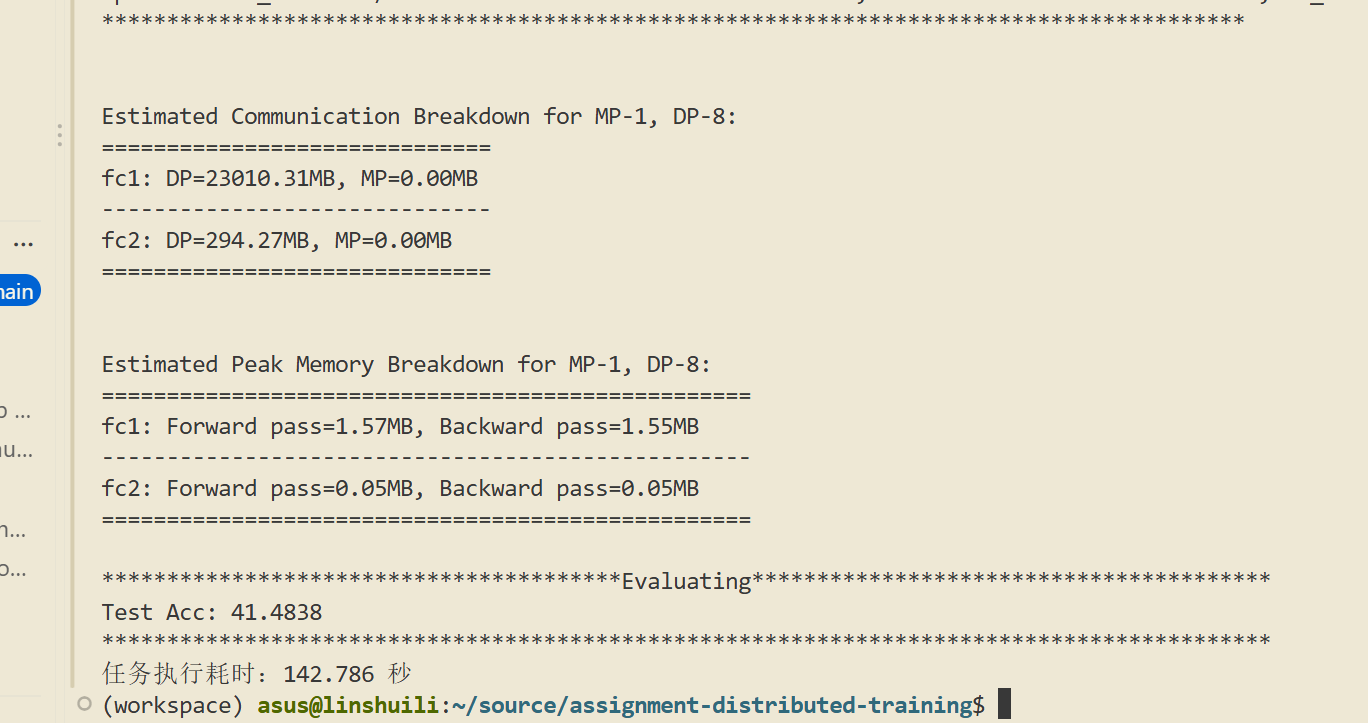
这个实验说明,MP结合DP,可以降低总的通信量。
实验2. megatron parallel
通信分析
MP
forward: Allreduce(y_fc2) (省去了fc1的comm)
backward: 0 (省去了所有通信)
DP
Allreduce(weight)
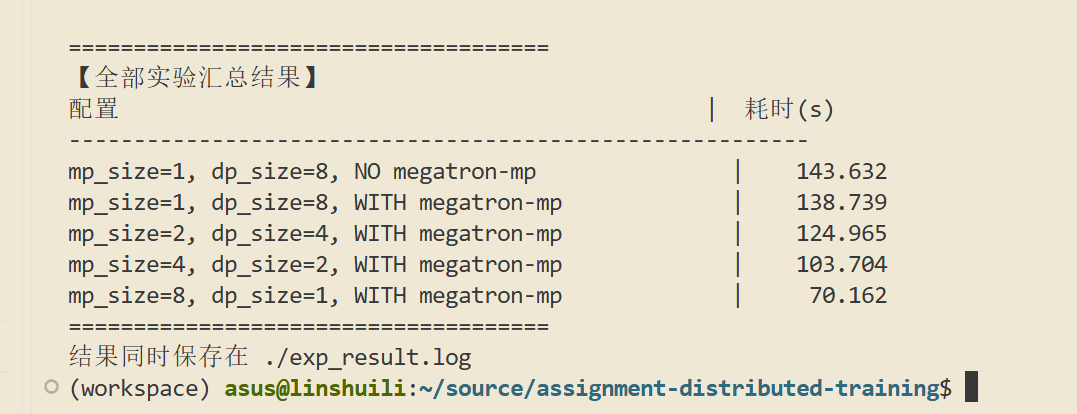
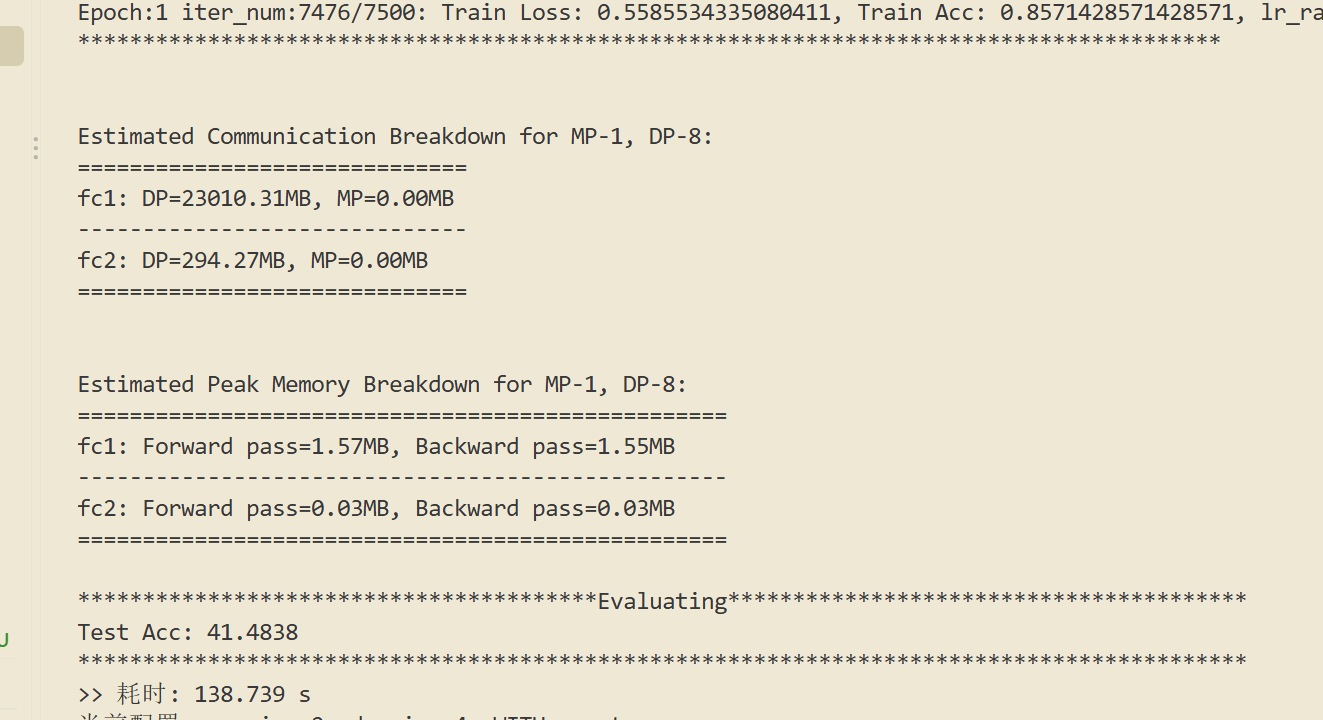
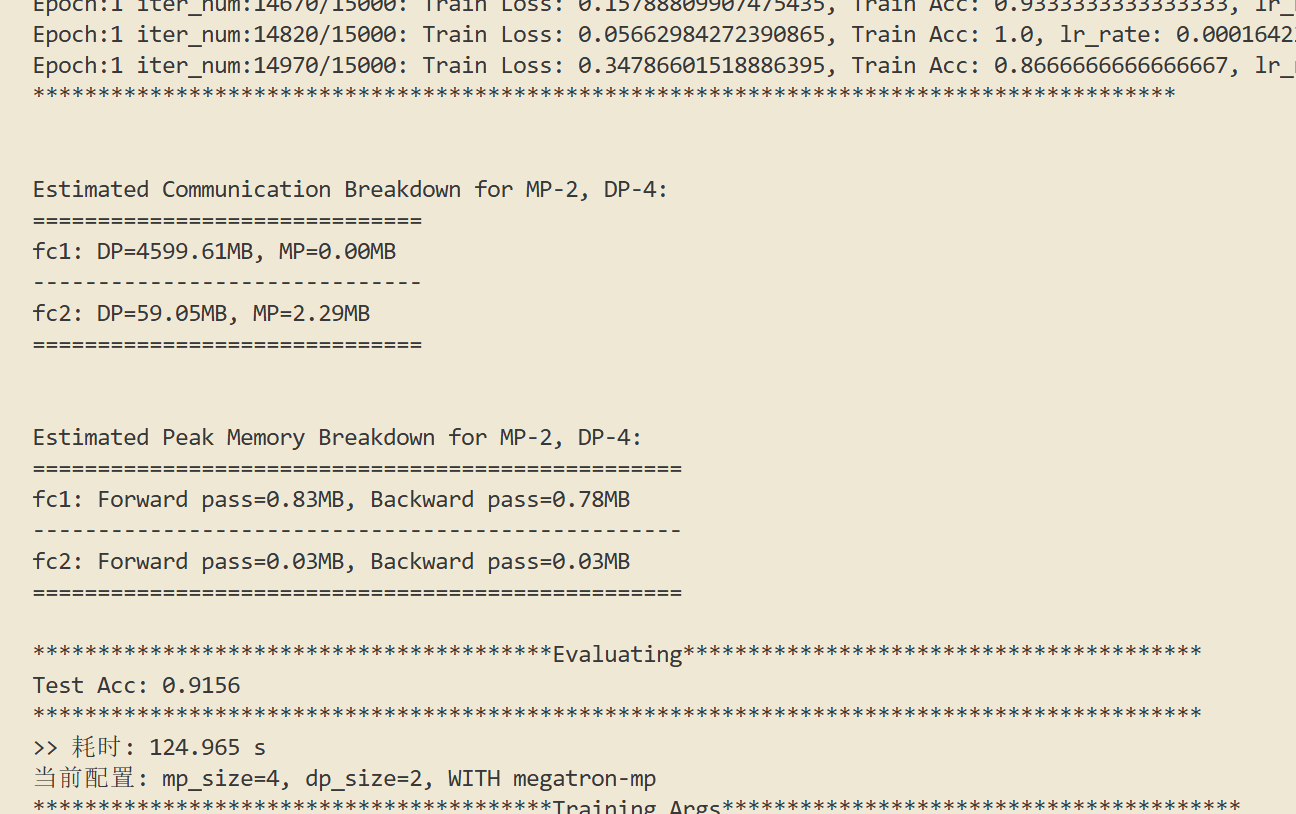
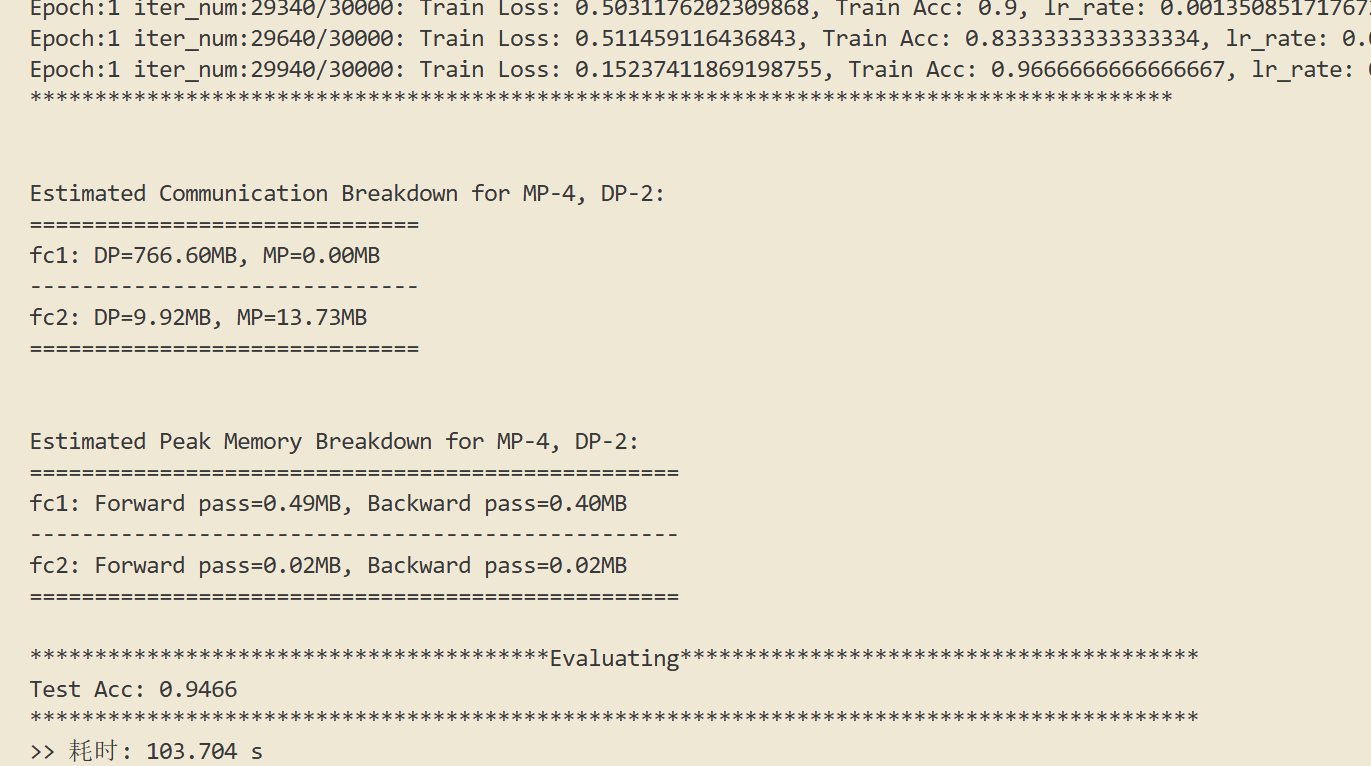
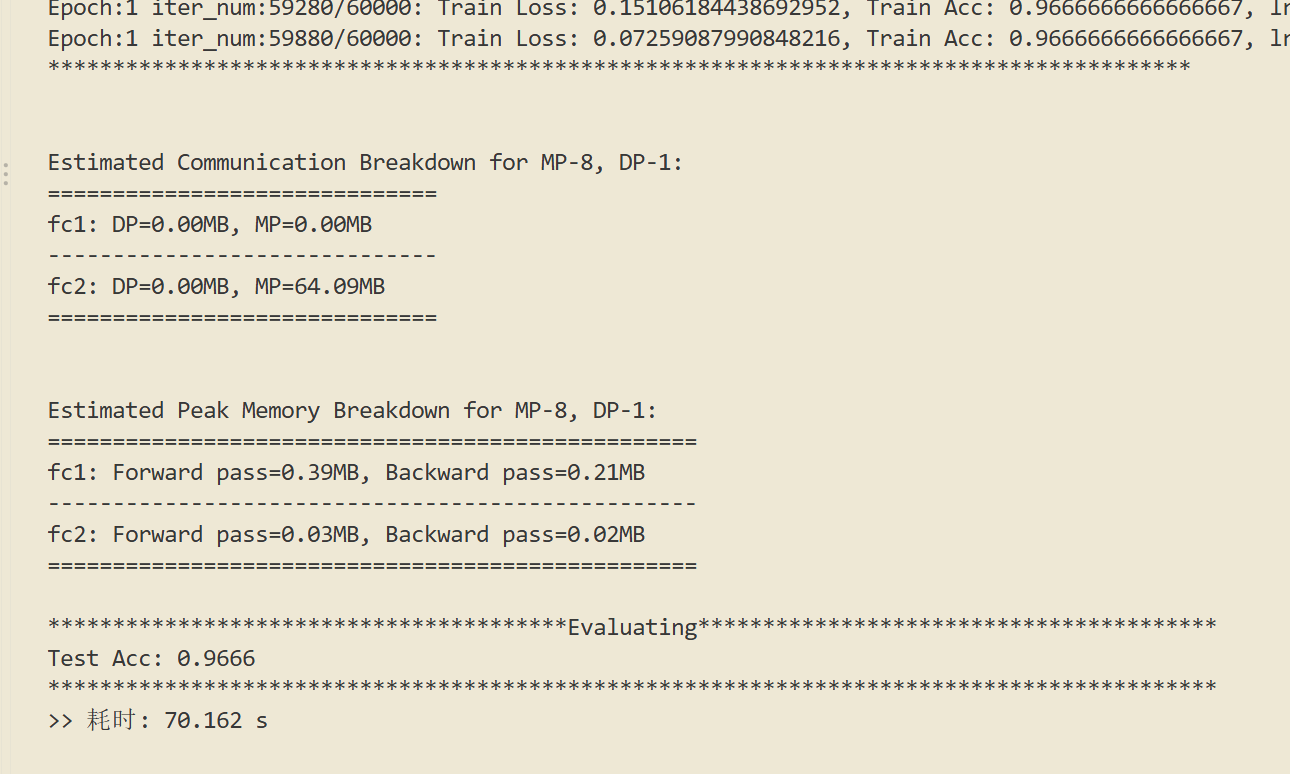
可以看到,前两种方法的DP通信开销是一样的,而megatron的实现方法是减少了MP的通信开销,所以十分的快速。
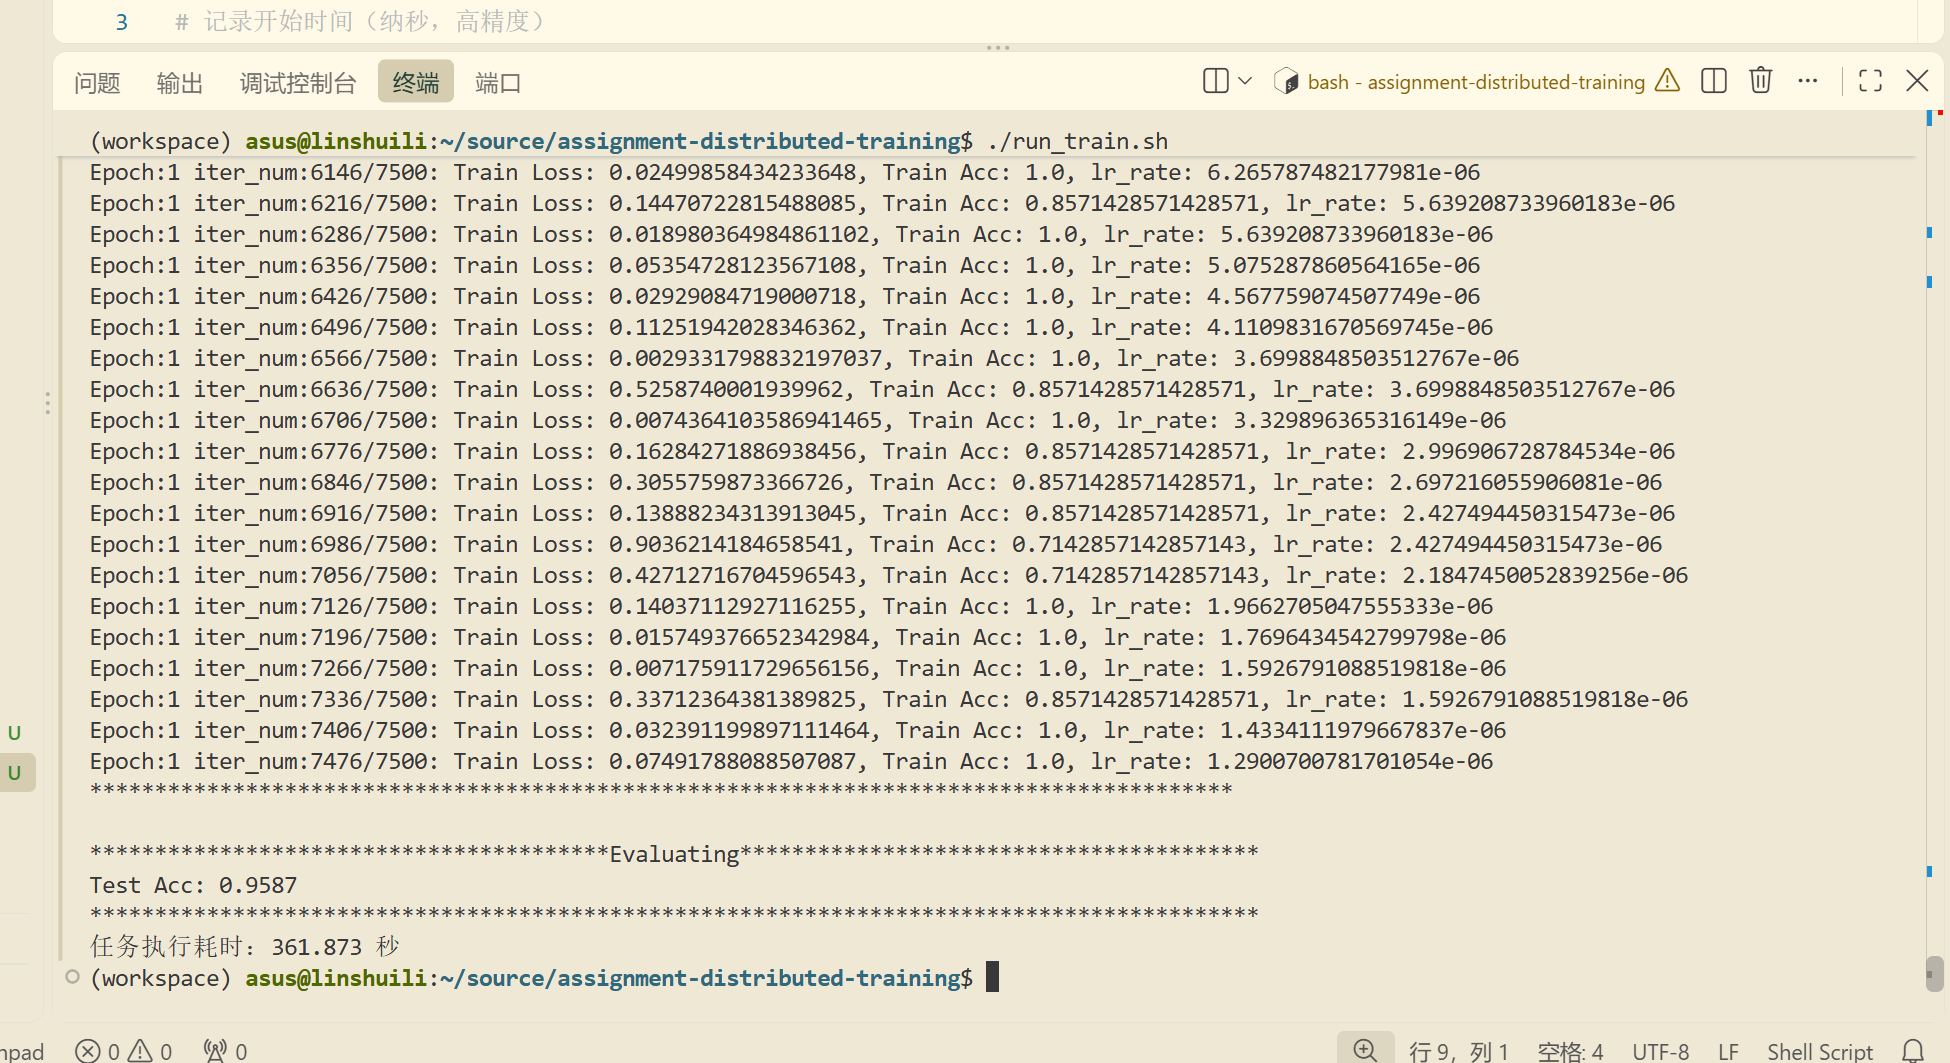
实验3. ZERO-DP parallel
通信点分析
forward: Allgather(weight_shard)
backward: Reduce_scatter(grad_weight)、Allgather(weight_shard)
dp_size = 8
总结
这个作业的实现相对简单,没有什么复杂的优化算法,也不需要写底层通信库,但能够清晰理解DP、MP、以及ZeRO的核心含义与简单实现过程。
综上所述,ZeRO相比前两种方法,以通信量增加的方式,节省了每个节点所需要的内存。优化的是DP的方法,因为其对weight的shard,导致MP无法与其结合产生有效优化。反而可能增加通信。
如果框架代码可以跟踪每个实现的节点模型内存占用的话就更好了,可惜没有写,所以本实验的对比不是特别全面。
与AI的对话归档
https://chat.qwen.ai/s/8dcc7508-8be2-4eb8-8290-4ab935901564?fev=0.3.12
https://chat.qwen.ai/s/8d3541b8-0660-49de-af8e-9bc6383b22f9?fev=0.3.12
https://chat.qwen.ai/s/ab387468-1534-4dfc-8939-4a7521bd70f0?fev=0.3.12